國研金獎─佳作獎
亮點成果:植物基因調控資料庫建置之高效能運算應用
使用平台:國網中心「台灣杉三號超級電腦生醫專用環境」
 國立成功大學熱帶植物與微生物科學研究所教授 張文綺(影像拍攝:科學人)
面對極端氣候、病蟲害與糧食安全等挑戰,如何從數萬個植物基因中快速找到關鍵的「候選基因」,是現代植物科學的重要課題。國立成功大學熱帶植物與微生物科學研究所教授張文綺團隊長期投入植物生物資訊研究,透過整合RNA-seq、ChIP-seq等多體學高通量定序資料,利用電腦分析與預測方法,從龐大的數據中重建複雜的基因調控網路,協助研究者縮小搜尋範圍,加速後續實驗驗證與作物研究。
從基因調控出發,串起龐大資料
「我從念博士班的時候,就一直往基因調控的方向做研究。」張文綺回憶,當初吸引她的是一個看似簡單的問題:一個基因究竟是怎麼被打開,又是怎麼被關起來的?
隨著次世代定序(NGS)技術發展,研究人員能取得的資料量越來越大,也讓她開始思考,能不能把不同實驗產生的資料整合起來,看見更完整的基因調控關係。「因為轉錄因子的調控其實不是一對一,而是多對多。」她解釋,一個轉錄因子可能調控許多基因,一個基因也可能同時受到多個轉錄因子影響。這樣複雜的關係,很難只靠逐一實驗掌握。
這樣的想法,成為植物基因調控分析系統PlantPAN的起點。研究團隊從公開資料庫收集世界各地的實驗資料,整合上百種植物的基因組、大量轉錄因子,以及ChIP-seq、RNA-seq、表觀遺傳等多體學資料。ChIP-seq可協助找出轉錄因子可能結合在DNA上的位置,RNA-seq則能了解不同條件下基因的表現變化,再搭配DNA序列與其他資訊,描繪基因調控網路。
其中一項核心資料,是轉錄因子與DNA結合的「序列矩陣」。團隊透過大量實驗資料整理出不同轉錄因子偏好的DNA序列模式,再利用這些模式預測它們可能調控哪些基因,並參考不同物種間的序列保守性,提高預測的可信度。
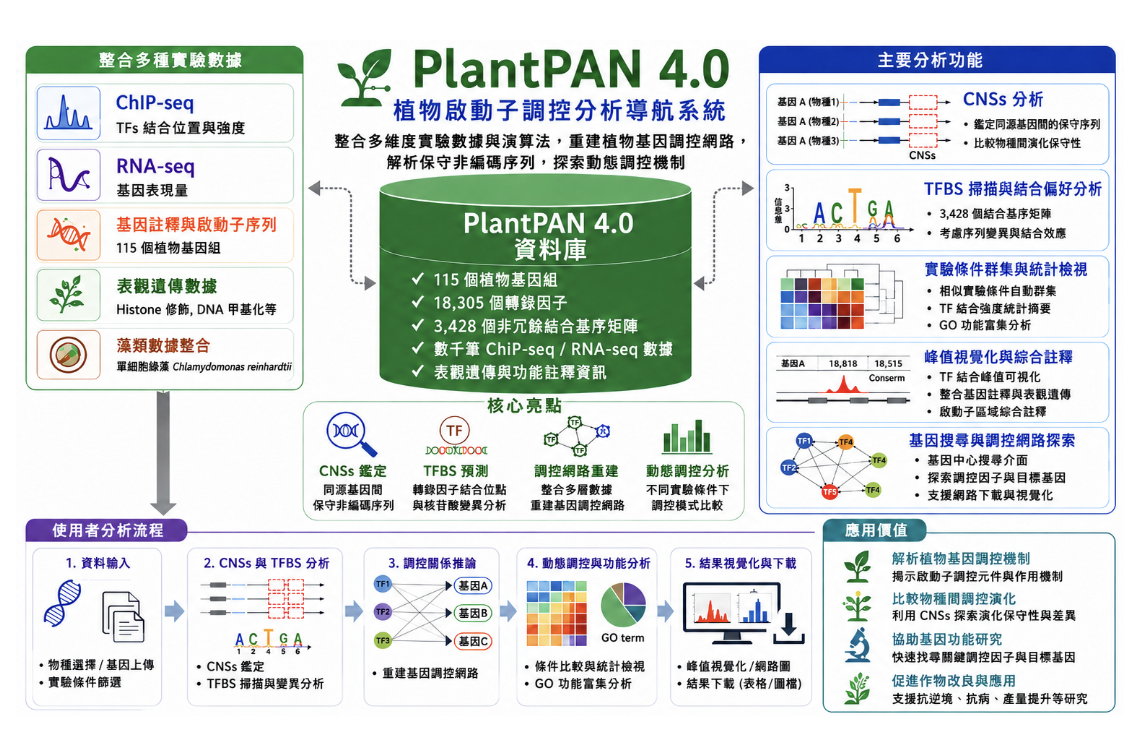 PlantPAN 4.0分析系統概念圖。(影像提供:張文綺)
另一套系統JustRNA,則聚焦於長鏈非編碼RNA(lncRNA)、miRNA等非編碼RNA,透過基因位置、表現變化與共表現關係,探索它們與其他基因之間可能形成的調控網路。
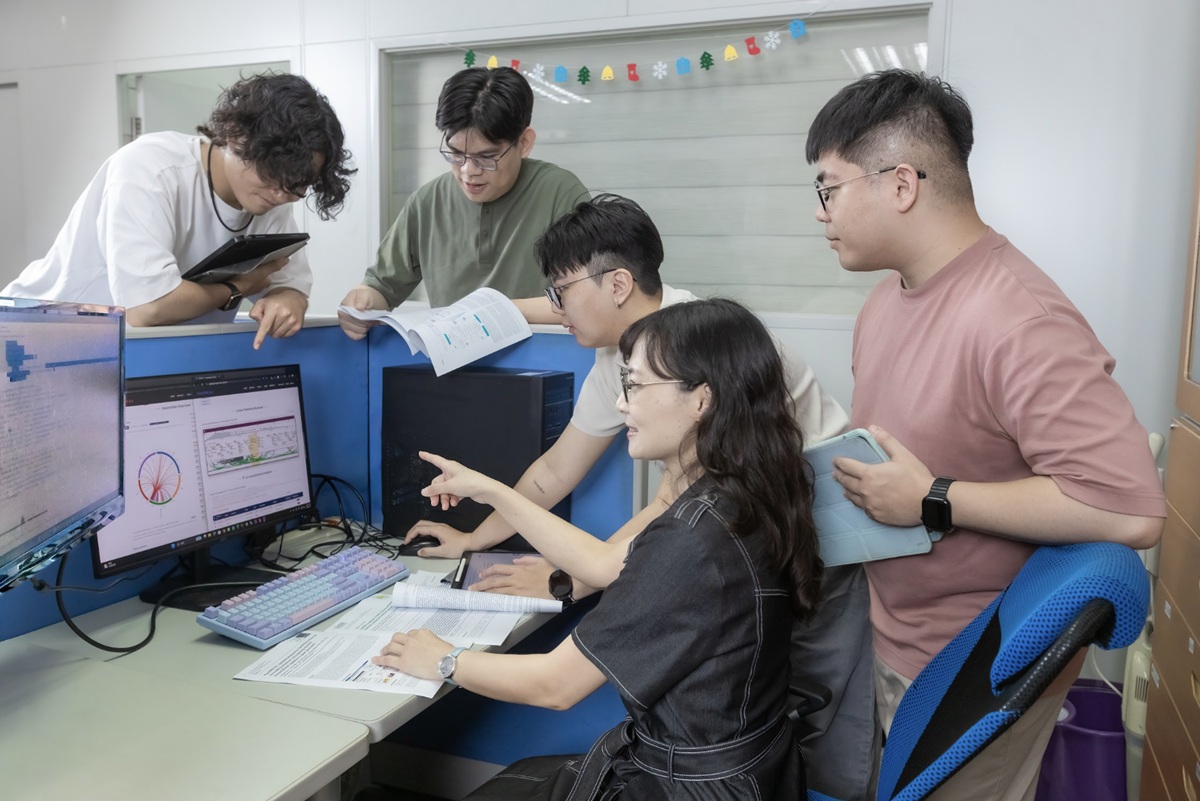 張文綺團隊結合國網中心 GP1 生醫算力資源,處理龐大的多體學定序資料,成功開發 PlantPAN 4.0 等高影響力植物生物資訊資料庫,為植物基因調控機制研究注入強大動能。(影像拍攝:科學人)
不過,建立這樣的資料庫,真正耗時的往往是前期的資料收集、整理與分類。由於不同研究團隊公開的資料格式與實驗條件不盡相同,張文綺團隊必須先以電腦進行篩選,再透過人工檢查資料品質,甚至捨棄部分不符合要求的資料。這些工作雖然繁瑣又費時,卻是確保資料庫品質不可或缺的一環。
高效能運算,讓資料整合更進一步
當資料量不斷增加,高效能運算也成為研究的重要基礎。大量NGS資料需要經過序列分析、組裝與基因表現量計算,部分資料甚至達到數十或上百GB。研究團隊除了使用實驗室伺服器,也透過國家高速網路與計算中心(簡稱國網中心)的平台資源處理大量資料。
張文綺表示,研究團隊約從PlantPAN 3.0開始使用國網中心的資源。隨著系統納入更多植物與多體學資料,運算需求也持續增加。她特別感謝國網中心GP1生技醫藥核心設施服務團隊,提供良好且穩定的運算環境,讓研究團隊能夠處理更大量的NGS資料,進一步擴充系統內容、完善資料整合,為PlantPAN 4.0與JustRNA的建立提供重要支援。到了2024年,PlantPAN 4.0已收錄115種植物,以及涵蓋18,305個轉錄因子的3,428個非冗餘矩陣(nonredundant matrices);JustRNA則收錄80種植物,共1,088,565筆lncRNA資料。
而這些散落在公開資料庫中的研究成果,還意外帶來了一個讓張文綺印象深刻的故事。PlantPAN 3.0發表後,張文綺收到國際農業公司先正達(Syngenta)的來信,希望取得資料庫中的核心轉錄因子結合矩陣資料,供公司進行大量分析與商業應用。由於過去主要從事學術研究,張文綺起初甚至以為這封信是詐騙,確認對方身分後,才發現對方確實有授權使用資料的需求。
對張文綺而言,這次授權不僅是研究成果獲得實際應用,也讓她第一次意識到,原本以學術研究為目的建立的資料庫,也可能產生研究之外的應用價值。
從學術資料庫走向國際,探索更多可能
研究團隊的努力也獲得國際學術界肯定,PlantPAN 4.0於2024年發表於《核酸研究》(Nucleic Acids Research),PlantPAN系統使用者來自超過60個國家,累積引用超過1,300次;JustRNA則於2023年發表於《實驗植物學》(Journal of Experimental Botany)。
「每個月都有上千人在使用PlantPAN,使用者的國家分布也很廣。」張文綺說。對她而言,分析系統的價值不只是提供查詢功能,更重要的是讓那些投入大量時間與經費取得的研究資料,在論文發表後仍能持續發揮作用,而不是逐漸被埋沒。畢竟,若耗費大量資源取得的資料在研究成果發表後便不再被利用,實在相當可惜。
目前PlantPAN已更新至5.0,持續納入更多多體學資料,也加入AI預測模型。未來團隊希望進一步整合蛋白質交互作用、基因型與表現型、單核苷酸多態性(SNP)等資訊,讓研究者能從基因變異與性狀之間的關係,尋找與抗病、環境適應等特徵相關的候選基因,並為基因編輯等研究提供線索。
從博士班時期對「基因如何被打開、關起來」的好奇,到建立整合大量公開資料的分析系統,張文綺與團隊把原本如同「大海撈針」的基因搜尋工作,轉化為有方向的資料導引。當散落各處的實驗數據重新連結,研究人員也就有機會從龐大資訊中,看見植物基因彼此之間複雜而精密的「指揮網路」。
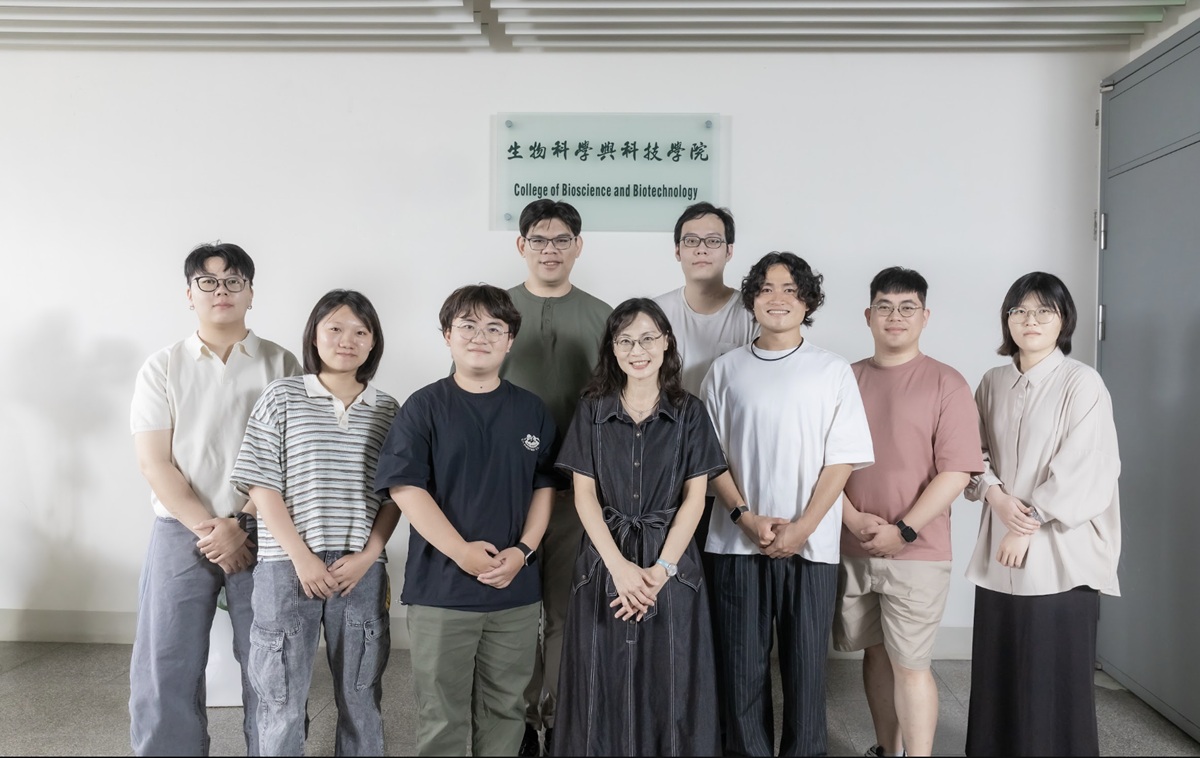 張文綺(前排中)與實驗室研究團隊成員合影。團隊長期深耕植物生物資訊領域,建置出享譽國際的植物基因調控分析平台。(影像拍攝:科學人)